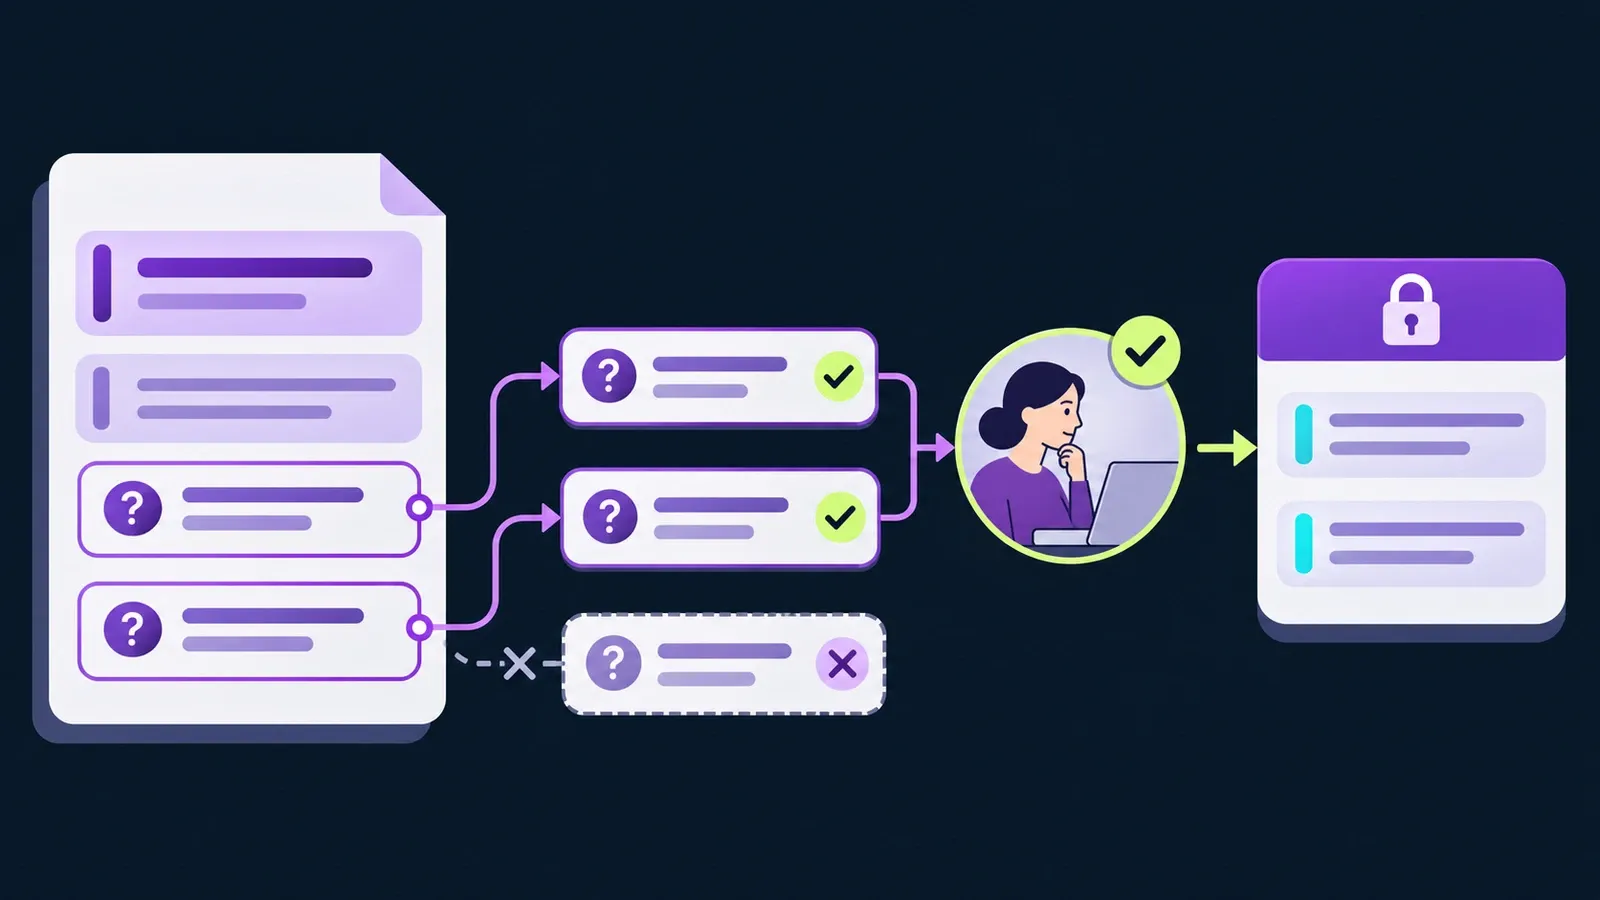
Num teste interno da Imara em produção, colocamos um questionário de due diligence em português para passar pelo nosso fluxo de respostas. Entre as perguntas detectadas estavam a introdução do documento, as instruções de preenchimento e a declaração de encerramento. E a IA estava preparando respostas para aquilo tudo.
O parser usava uma regex para identificar linhas numeradas. Encontrou um número no começo da introdução e fez o que havíamos programado: transformou aquela linha numa pergunta. Depois veio a chamada ao modelo, o processamento e um rascunho que ninguém precisava ter escrito. O mesmo aconteceu com as instruções e com a declaração final.
Quem já precisou responder a um questionário de segurança sabe o trabalho que dá conferir o que uma empresa pode afirmar sobre seus controles. Se a ferramenta acrescenta perguntas que não existem, ela aumenta justamente o trabalho que deveria ajudar a resolver. A pessoa passa a revisar também os erros que nós introduzimos no caminho.
No primeiro artigo desta categoria, escrevi sobre a autonomia que quero construir para quem usa a Imara. Esse teste mostrou uma parte bem concreta do que isso exige. Antes de pedir à IA que respondesse melhor, precisávamos cuidar de como uma parte do documento ganhava o direito de virar pergunta.
O erro começou antes da primeira resposta
O resultado do parser passava pelas validações de estrutura. Tinha uma lista de itens, referências e texto nos campos esperados. Para o código que vinha depois, havia trabalho legítimo para fazer. A diferença entre uma instrução e uma pergunta tinha se perdido logo na entrada, e o restante do sistema carregava essa decisão adiante.
Esse é um erro fácil de deixar passar quando cada componente é avaliado isoladamente. A extração encontrou texto, o objeto estava bem formado e o modelo devolveu uma resposta. Só que, ao olhar o fluxo pela perspectiva de quem ia usar o resultado, ficava evidente que estávamos resolvendo o problema errado.
A partir daí, separamos as responsabilidades. Primeiro extraímos o texto. Depois o modelo classifica os trechos. O código verifica se o que ele devolveu existe na fonte. Por fim, uma pessoa confere as perguntas detectadas. Cada etapa responde a uma dúvida diferente, e nenhuma delas recebe autorização para assumir o trabalho da próxima.
Ler o arquivo e entender o documento são trabalhos diferentes
Um PDF ou um arquivo Word chega com problemas que existem antes de qualquer chamada ao modelo. Pode estar corrompido, ter páginas sem texto, conter estruturas muito grandes ou exigir recursos demais do leitor. Por isso, começamos por uma extração limitada de PDF, DOCX ou texto simples, com limites para o arquivo, a expansão de conteúdo compactado, o texto extraído e o tempo de processamento.
Quando um desses limites é ultrapassado, recusamos o processamento. Cortar o documento e seguir adiante produziria uma situação difícil de perceber: o sistema poderia apresentar uma lista aparentemente completa depois de ter lido só uma parte do arquivo.
Também preservamos a diferença entre uma página física de PDF e um segmento lógico de texto extraído de DOCX. Isso aparece na hora de voltar à origem. Não adianta mostrar uma referência precisa na interface se aquela “página” foi criada pelo nosso próprio leitor e não corresponde à paginação do documento.
Com o texto extraído, pedimos ao modelo que identifique perguntas, títulos, instruções, declarações e outros conteúdos. Guardar essas diferenças importa. “Responda Sim ou Não e justifique” ajuda a entender como responder ao questionário, mas não precisa receber uma resposta própria. A declaração final também tem um papel diferente de uma pergunta sobre backups.
Fazemos essa classificação em janelas de páginas, com sobreposição de uma página entre elas. Assim, uma pergunta que começa no fim de uma página pode ser interpretada junto da sua continuação. O custo dessa escolha é ter de reconciliar os resultados: remover a mesma ocorrência detectada duas vezes e distinguir um fragmento da pergunta completa. Duas perguntas iguais em lugares diferentes, por outro lado, precisam continuar existindo. É a posição na fonte que ajuda a separar esses casos.
Se não está na fonte, não entra na lista
Usar um modelo para interpretar a estrutura do documento resolveu a limitação da regex, mas trouxe outra responsabilidade. O texto devolvido pela IA também precisa ser conferido. Pedimos que ela cite os trechos do documento; a decisão de aceitá-los fica com o código.
Para cada item, procuramos o texto na janela que foi fornecida ao modelo. A comparação trata diferenças de espaços, caixa e representação Unicode, mantendo um mapa para recuperar as posições e o texto originais. Quando há correspondência, guardamos a localização. Quando não há, rejeitamos o item. O resultado fica incompleto e não recebe autorização para avançar como se tudo tivesse dado certo.
O exemplo abaixo reduz essa ideia ao essencial. É uma adaptação didática de packages/ai/src/questionnaires/parse.ts, revisão ae5a0b06b532, não código de produção. O documento e a pergunta inventada são ilustrativos; aqui usamos comparação literal para deixar a rejeição visível.
type Item = { kind: 'question' | 'heading' | 'instruction' | 'declaration'; text: string;};type Checked = | { ok: true; item: Item; start: number; end: number } | { ok: false; reason: 'unsupported_source'; item: Item };function verify(source: string, item: Item): Checked { const start = item.text.length ? source.indexOf(item.text) : -1; if (start < 0) { return { ok: false, reason: 'unsupported_source', item }; } return { ok: true, item, start, end: start + item.text.length };}const source = 'Segurança\nA empresa utiliza MFA?';const candidates: Item[] = [ { kind: 'question', text: 'A empresa utiliza MFA?' }, { kind: 'question', text: 'A empresa possui SOC 2?' }, // inventado];const checked = candidates.map(item => verify(source, item));const accepted = checked.filter(result => result.ok);const rejected = checked.filter(result => !result.ok);console.log(accepted.length, rejected.length); // 1, 1
A pergunta sobre SOC 2 não aparece na fonte e é rejeitada. Na implementação, precisamos lidar também com normalização, localização dos trechos, reconciliação das janelas e consistência do estado salvo. Uma busca por substring, sozinha, não resolve alucinações de maneira geral.
E existe um limite que merece ficar claro: encontrar o texto não prova que o modelo o classificou corretamente. A nossa introdução numerada continuaria passando numa verificação de presença. Ela está no documento. O erro é chamá-la de pergunta. Essa checagem também não demonstra que todas as perguntas foram encontradas e não diz nada sobre a correção das respostas que serão geradas depois. Por isso, a conferência da lista continua necessária.
O que acontece quando o trabalho termina fora de ordem
Até aqui, o fluxo parece uma sequência simples. Mas ele roda em segundo plano, sujeito a demora do provedor, interrupção do processo e novas tentativas iniciadas pela pessoa. Precisávamos garantir que o documento conferido no começo continuasse sendo o mesmo e que um resultado atrasado não substituísse trabalho mais recente.
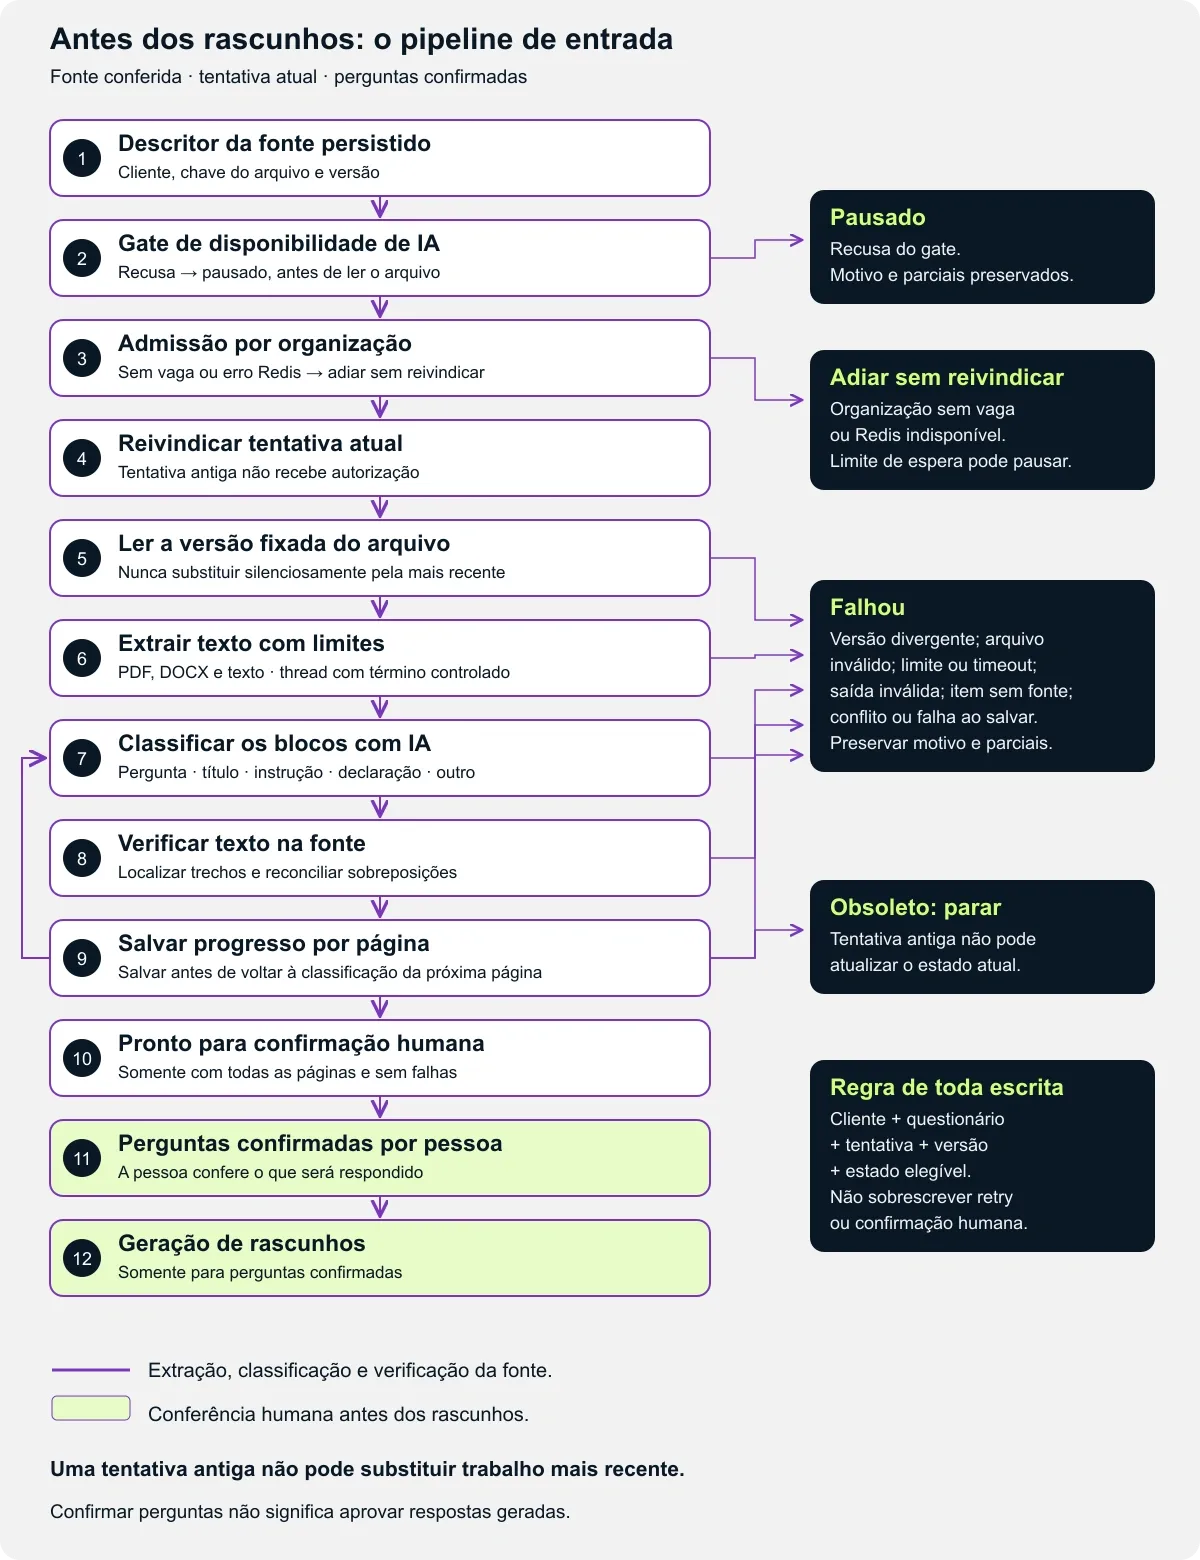
O job lê um descritor persistido, associado à organização, que aponta para uma versão específica do arquivo no S3. Ele não recebe liberdade para escolher outra chave a partir da mensagem da fila. Se aquela versão estiver ausente ou for divergente, o processamento falha. Buscar silenciosamente a versão mais recente significaria trocar a fonte enquanto o trabalho acontece.
Para a execução, usamos um identificador de tentativa. Imagine que a tentativa A demore, a pessoa inicie B e, depois, A finalmente termine. Se a gravação procurar apenas o identificador do questionário, A pode apagar o resultado de B. O mesmo cuidado vale para uma lista que uma pessoa já conferiu e confirmou.
Por isso, cada escrita exige correspondência entre organização, questionário, tentativa, versão da fonte e estado ainda elegível para processamento. Se alguma dessas condições mudou, o job antigo perde o direito de atualizar o registro. Cancelá-lo ajuda a economizar recursos, mas essa proteção precisa existir na escrita no banco, mesmo quando o cancelamento chega tarde.
Também salvamos o progresso a cada página e aguardamos essa gravação antes da próxima chamada ao modelo. Uma interrupção preserva os itens já detectados e o motivo da parada. A retomada pode aproveitar esse trabalho quando a versão do prompt continua a mesma e os itens salvos passam novamente pela verificação da fonte. Se não passarem, o parsing recomeça. Assim conseguimos recuperar trabalho sem transformar um resultado parcial em sucesso.
Um arquivo ruim não pode parar o resto da operação
Enquanto um questionário é processado, a plataforma continua atendendo pessoas, executando verificações e recebendo outros documentos. Um arquivo que trava o leitor ou uma organização que concentra muitas operações de IA precisa encontrar limites antes de comprometer esse trabalho.
O fluxo passa primeiro pela verificação de disponibilidade da IA e depois pela admissão por organização. Uma recusa de disponibilidade deixa o processamento pausado, com um motivo. Falta de vaga adia o job antes de reivindicar a tentativa. Também não usamos uma falha no Redis como justificativa para deixar todo mundo passar.
O protocolo define um conjunto de três permissões por organização, compartilhável entre parsing, geração e consultas ao assistente. Esse número é uma decisão de concorrência, não uma medida de desempenho. Ele precisa conviver com limites globais, prazo máximo dos jobs e capacidade do provedor. As permissões têm prazo de validade e só podem ser liberadas pelo processo que as adquiriu.
Organizamos o parsing num serviço dedicado para controlar essa carga separadamente do worker de conformidade. Dentro dele, a extração roda em uma worker thread que pode ser encerrada se o leitor travar. Isso oferece uma fronteira de término; não cria um sandbox de segurança do sistema operacional. Limitar o heap do V8 também não limita toda a memória nativa ou RSS. Permissões mínimas, isolamento do contêiner e limites de recursos continuam fazendo parte da solução.
O banco participa em transações curtas. Não precisamos manter uma conexão ocupada enquanto um arquivo é lido ou um provedor prepara a resposta. São escolhas pouco visíveis para quem usa a plataforma, mas que determinam se a automação consegue conviver com o restante do produto.
A pessoa precisa saber o que está confirmando
Quando o parsing termina com sucesso, chegamos à conferência dos itens detectados. As perguntas vêm selecionadas por padrão, mas seleção automática não vale como confirmação humana. A pessoa precisa poder olhar a lista e decidir se aquilo representa o questionário que recebeu.
Essa passagem fica protegida na API e no worker de geração. Esconder um botão na tela seria insuficiente: um job antigo ou uma chamada direta poderia tentar seguir por outro caminho. Parsing pausado, falho ou ainda sem confirmação não pode liberar rascunhos. E, se a IA estiver indisponível, voltar à mesma regex que confundiu introduções com perguntas apenas esconderia o problema.
Confirmar as perguntas também não significa aprovar as respostas. São decisões tomadas em momentos diferentes. Na primeira, a pessoa define o que será respondido. Depois da geração, ela precisa avaliar as afirmações preparadas em nome da empresa. Uma introdução não deveria consumir essa atenção, assim como uma resposta bem escrita não deveria dispensar essa revisão.
É esse tipo de aprendizado que quero compartilhar nesta categoria. A ideia de ajudar a responder um questionário parece simples até encontrarmos todos os lugares em que uma decisão errada pode ganhar aparência de trabalho concluído. Tratar a saída do modelo como entrada não confiável é o começo. Na prática, precisamos verificar a fonte e escrever as garantias do fluxo no código, para que uma lista inválida ou uma tentativa antiga não consiga liberar a próxima etapa.